Sur cette page
Notre avis sur Qwen 3 TTS
Qwen 3 TTS intéresse surtout les équipes qui veulent contrôler leur pile vocale ou intégrer une API au caractère sans adopter un studio créatif complet.
Le dépôt publie des variantes 0,6B et 1,7B pour voix prédéfinies, Voice Design et clonage. L’ouverture des poids facilite l’expérimentation, mais transfère exploitation, latence, sécurité et capacité GPU vers l’équipe qui héberge.
L’API réduit ce coût opérationnel et fournit un tarif lisible par caractères. Les prix et quotas diffèrent par région et durée d’activation : utilisez le tableau international comme repère daté, puis contrôlez la console avant production.
Nature et accès de Qwen 3 TTS
La famille Qwen3-TTS de modèles de synthèse et clonage vocal, pas une application de studio.
Interfaces : API.
Le critère qui compte
Les poids ouverts donnent du contrôle ; ils ne rendent ni le calcul, ni les droits de voix, ni l’exploitation gratuits.
Fonctionnalités de Qwen 3 TTS
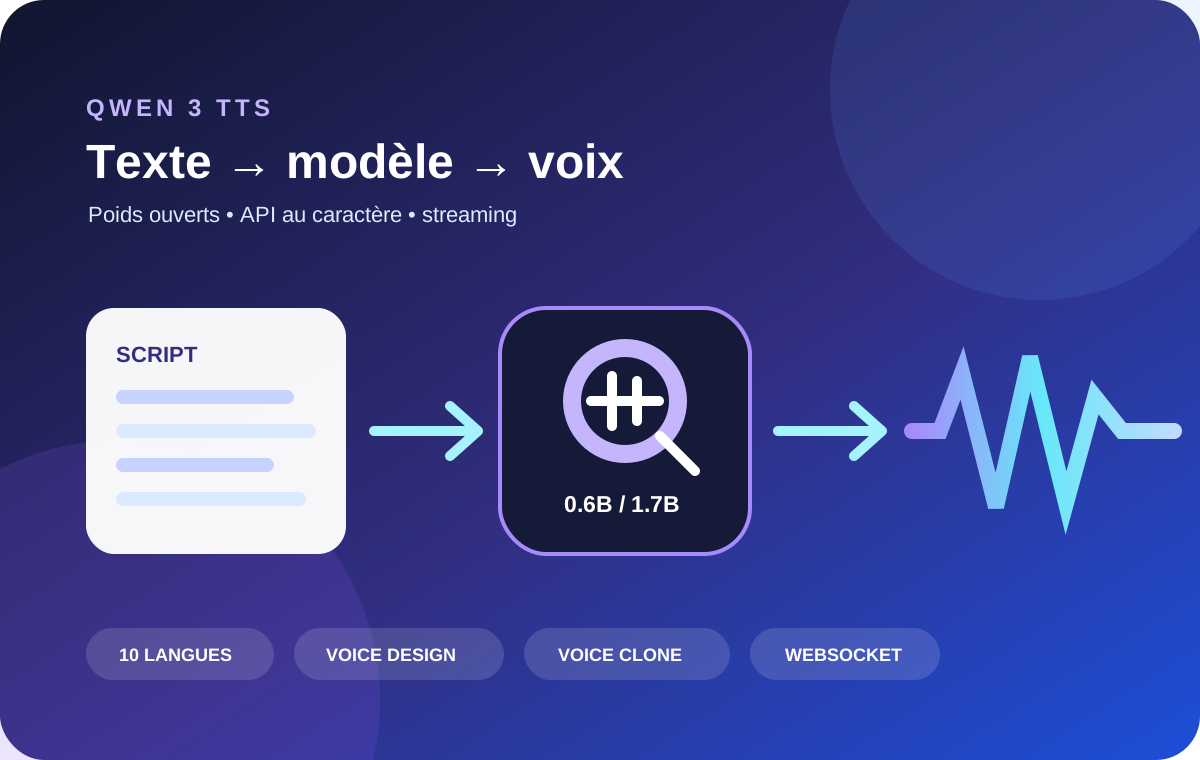
La gamme sépare voix prédéfinies, conception de voix, clonage et diffusion en continu afin de couvrir des pipelines différents.
Variantes 0,6B et 1,7B
Les deux tailles permettent d’arbitrer empreinte et ambition de qualité. Le dépôt fournit des exemples Python et des poids sur Hugging Face ou ModelScope ; la mémoire réelle dépend de la précision, de la concurrence et du serveur choisi.
Custom Voice multilingue
Les variantes Custom Voice utilisent des voix prédéfinies dans dix langues annoncées, dont le français. Elles constituent le chemin le plus simple pour comparer diction et style sans préparer un échantillon de clonage.
Voice Design sur instruction
Voice Design fabrique un profil à partir d’une description. Les instructions du service sont documentées en chinois ou en anglais sur certains modèles, même si le texte synthétisé peut être français.
Base pour clonage autorisé
La variante Base reproduit les caractéristiques d’un échantillon. Il faut isoler bruit et musique, conserver la preuve de consentement et prévoir une procédure de retrait ; la licence du modèle ne couvre pas la personnalité imitée.
Streaming et API WebSocket
Les modèles temps réel acceptent une production progressive. Formats PCM, WAV, MP3 ou Opus et fréquences disponibles varient selon l’endpoint ; choisissez-les d’après téléphonie, navigateur ou montage.
Déploiement local maîtrisé
L’auto-hébergement garde les scripts et fichiers dans l’infrastructure choisie, mais impose supervision, capacité GPU, mises à jour et politique d’accès. FlashAttention 2 est recommandé dans le dépôt pour accélérer l’exécution.
Qwen 3 TTS est une famille de briques vocales, pas un studio universel prêt à livrer. Le dépôt permet d’exécuter des poids 0,6B ou 1,7B ; Model Studio propose des endpoints facturés au caractère. Cette dualité est utile à condition de choisir d’abord qui exploitera la pile et quelles données pourront la traverser.
Choisir un mode d’exécution avant un modèle
L’API convient à une qualification rapide. Elle évite de réserver un GPU, expose des variantes stables et transforme le texte en coût mesurable. L’équipe reste toutefois dépendante d’une région, de quotas, de limites de requête et des conditions du service. Vérifiez ces éléments dans la console associée à la clé réellement utilisée.
Le local donne davantage de contrôle sur les scripts et l’environnement. En échange, il faut installer la chaîne Python, dimensionner la mémoire, superviser le service, gérer les versions et mesurer la concurrence. « Gratuit à télécharger » ne signifie donc ni calcul gratuit ni disponibilité garantie.
Le dépôt distingue plusieurs usages : voix fournies, création par description et reproduction à partir d’un échantillon. Commencez par la fonction la moins sensible qui répond au besoin. Pour une simple narration, une voix prédéfinie évite les contraintes supplémentaires d’un profil créé ou cloné.
Lire les prix par modèle et par région
Le tableau Alibaba Cloud actuel affiche Qwen3-TTS-Flash non temps réel à 0,10 $ pour 10 000 caractères en région International. Instruct Flash, Voice Design et Voice Clone sont indiqués à 0,115 $. Les endpoints temps réel sont distincts : Flash Realtime est à 0,13 $, tandis qu’Instruct Flash Realtime est à 0,143 $ et certaines variantes atteignent 0,143353 $.
Les versions stables actuelles de Flash, Instruct Flash, Voice Design et Voice Clone disposent de 110 000 caractères gratuits pendant 90 jours. Des snapshots plus anciens peuvent afficher seulement 10 000 caractères ; l’identifiant du modèle doit donc figurer dans votre relevé. Ne transposez jamais le prix ou le quota d’un endpoint realtime vers une carte standard.
Estimez le volume à partir du texte réellement envoyé, puis ajoutez les reprises. Un passage régénéré après une mauvaise diction est facturé une seconde fois. Pour comparer avec un abonnement de studio, additionnez également le temps de découpage, d’écoute, de normalisation et de montage.
Séparer timbre, conception et clonage
Custom Voice utilise des timbres fournis par Qwen et constitue le chemin le plus simple pour tester le français. Voice Design fabrique un profil à partir d’une description : définissez registre, énergie, rythme et contexte sans imiter une personne. La variante Base sert au clonage et réclame un échantillon propre ainsi qu’une autorisation explicite.
La licence Apache 2.0 du code et des poids ne couvre pas les droits attachés à une voix humaine. Conservez la preuve du consentement, le périmètre d’exploitation et une procédure de retrait. Pour un personnage ou une marque, documentez aussi qui peut modifier le profil et dans quels contenus il peut apparaître.
Dix langues sont annoncées, dont le français. Cette couverture ne prédit pas la qualité sur un texte métier. Composez un corpus avec noms propres, sigles, unités, nombres, ponctuation ambiguë et phrases longues. Évaluez chaque erreur selon son effet sur le livrable, pas selon une impression globale de naturel.
Qualifier un pipeline vocal complet
Générez le même corpus avec l’endpoint choisi et, si le contrôle local est envisagé, avec la variante de poids ciblée. Enregistrez identifiant, version, paramètres, format, fréquence et durée. Pour le temps réel, mesurez connexion, premier paquet audio, interruptions et délai final sur le réseau de production.
Écoutez ensuite les raccords entre segments. Une voix convaincante sur dix secondes peut dériver sur un module long : volume, cadence ou prononciation changent entre blocs. Fixez des règles de segmentation et un dictionnaire avant de lancer de gros volumes.
Qwen 3 TTS est pertinent pour une équipe technique qui veut intégrer une fonction vocale, contrôler davantage son infrastructure ou comparer un coût au caractère. Un créateur qui privilégie une interface guidée, le montage et une bibliothèque immédiatement exploitable trouvera souvent ElevenLabs ou Murf AI plus directs.
La décision doit enfin inclure les données et les droits. L’API réduit l’effort d’exploitation ; le local réduit certains transferts mais ajoute des responsabilités. Retenez la voie qui respecte vos contraintes après un essai reproductible, sans faire du faible prix un substitut à la qualité ni au consentement.
À qui Qwen 3 TTS convient-il ?
Le projet vise les développeurs et équipes audio capables de choisir entre API managée et exploitation de poids ouverts.
Particulièrement adapté
- Développeurs intégrant une fonction vocale
- Équipes voulant évaluer des poids ouverts
- Produits multilingues capables de gérer consentement et observabilité
Moins adapté
- Créateurs cherchant un studio sans code
- Équipes sans capacité d’exploitation GPU
- Projets de clonage sans autorisation explicite
L’ouverture du modèle et les droits sur les données d’entraînement ne valent pas autorisation d’imiter une personne.
En bref
Forces et limites de Qwen 3 TTS
Ce qu’on aime
- Poids Apache 2.0 et plusieurs tailles
- Voix conception clonage et streaming réunis
- API au caractère pour démarrer sans GPU
Ce qui peut frustrer
- Exploitation locale à financer
- Tarifs et quotas dépendants de la région
- Interface de production moins guidée qu’un studio SaaS
Prix Qwen 3 TTS : open source, API et création de voix
Les poids sont téléchargeables sous Apache 2.0, mais leur exploitation a un coût. En région International, Qwen3-TTS-Flash non temps réel est affiché à 0,10 $ pour 10 000 caractères et Instruct Flash à 0,115 $, avec 110 000 caractères gratuits pendant 90 jours pour les versions stables actuelles.
Open source local0 $ hors machine+
Repo officiel QwenLM/Qwen3-TTS sous licence Apache-2.0
Capacité : Selon usage
Qwen3-TTS-Flash InternationalNotre choix0,10 $ / 10k caractères+
Génération vocale standard via Alibaba Cloud Model Studio
Capacité : Selon usage
Qwen3-TTS Realtime International0,13 à 0,143353 $ / 10k caractères+
API WebSocket pour voix temps réel
Capacité : Selon usage
Le calcul local inclut GPU stockage et supervision
Prix et quotas API changent selon région modèle et date d’activation
Alternatives à Qwen 3 TTS
ElevenLabs apporte un studio complet, Murf structure la voix off business et Fish Audio propose une voie API ; Qwen se distingue surtout par ses poids et ses variantes.
Qwen 3 TTS, ElevenLabs, Murf AI ou Fish Audio ?
Le choix oppose contrôle de la pile, confort de studio et simplicité d’API.
| Outil | Priorité | Accès | Limite |
|---|---|---|---|
| Qwen 3 TTSNotre choix | Poids ouverts et intégration | Local ou API au caractère | Exploitation technique |
| ElevenLabs | Production audio créative | Studio et API | Dépendance au service |
| Murf AI | Voix off business | Studio et intégrations | Clonage Enterprise |
| Fish Audio | API vocale | Service managé | Contrôle local différent |
Voix IA open source
Testez Qwen 3 TTS sur un vrai script
Le bon essai tient en 30 secondes : français, nom propre, acronyme, phrase longue et volume mensuel estimé. Si le rendu tient, Qwen peut devenir une brique TTS très rationnelle.
À savoir : Apache 2.0 ne vous accorde aucun droit sur une voix source ; documentez le consentement et chiffrez l’infrastructure locale.
Questions fréquentes sur Qwen 3 TTS
Qwen 3 TTS est-il gratuit ?
Oui pour les modèles open source si vous les exécutez vous-même. L'API Alibaba Cloud est payante au caractère, avec des quotas gratuits temporaires selon le modèle et le mode de déploiement.
Qwen 3 TTS fonctionne-t-il en français ?
Oui. Le repo officiel liste le français parmi les langues supportées. Pour publier, testez quand même noms propres, acronymes et phrases longues sur votre script réel.
Peut-on cloner une voix avec Qwen 3 TTS ?
Oui, via Voice Clone. L'usage doit reposer sur une voix autorisée et des droits clairs, surtout en contexte commercial.
Quel modèle Qwen 3 TTS choisir pour commencer ?
Qwen3-TTS-Flash API est le meilleur premier essai pour écouter un rendu sans installation. En local, commencez par 0.6B si la machine est limitée, puis comparez avec 1.7B si la qualité devient prioritaire.
Qwen 3 TTS remplace-t-il ElevenLabs ?
Il peut remplacer ElevenLabs si votre priorité est le coût, le self-hosting ou l'API. ElevenLabs reste plus simple pour produire vite dans une interface de studio.